После того как модель проходит необходимый порог качества, выбор между закреплением за сессией (pin-to-session) и роутингом по вызовам (per-call routing) становится расчётом окупаемости с учётом состояния. При первом переходе на другую модель ей может потребоваться обработать накопленный префикс по тарифу записи в кеш или обычного ввода. Но кеш исходной модели не обязательно исчезает: при возврате можно повторно использовать самый длинный совпадающий префикс, пока запись остаётся доступной. Поэтому роутер должен сравнивать полную ожидаемую стоимость на всём оставшемся участке работы и хранить состояние кеша отдельно для каждой модели. В расчёт должны входить записи кеша, кеш-чтения, обычный ввод, выходные токены, ожидаемые повторы и вероятность того, что прежняя кеш-запись останется живой к моменту возврата.
Поэтому кеширование промпта (prompt caching) должно входить в политику роутинга, а не оставаться особенностью биллинга, которую замечают уже после запуска. Закрепление одной модели за задачей выгодно при длинном стабильном контексте, который используется много раз. Роутинг по вызовам выгоден, когда префикс короткий или уже холодный либо когда разница в сложности шагов достаточно велика, чтобы окупить переключение.
Контекстом я называю весь ввод модели в текущем вызове: системные инструкции, определения инструментов, историю и новый запрос. Префикс — неизменная начальная часть этого ввода. Провайдер один раз обрабатывает совпадающий префикс, сохраняет KV-состояние для конкретной модели, а при следующем вызове читает его из кеша и обрабатывает только изменившийся хвост.
Две стратегии оптимизируют разные единицы работы
Закрепление модели за сессией выбирает исполнителя в начале задачи и оставляет на нём сбор данных, выполнение действий и проверку результата. Единицей оптимизации становится вся задача. Роутер может оставаться простым, поскольку принимает одно важное решение, а порог качества и резервная модель защищают от неудачного назначения.
Роутинг по вызовам выбирает модель отдельно для каждого шага. Небольшая недорогая модель может собрать простые данные, более сильная — выполнить сложное действие, а ещё одна недорогая модель — проверить структуру результата. Харнесс остаётся прежним, но выбор модели переносится внутрь его цикла. Требования к возможностям модели меняются от шага к шагу, поэтому меняется и решение роутера.
Обе конструкции логичны. Граница оптимизации у них проходит в разных местах. Закрепление защищает непрерывность провайдерского кеша. Роутинг по вызовам использует разницу в сложности шагов. Конфликт возникает, когда экономию на отдельном шаге считают так, словно накопленный контекст переезжает между моделями бесплатно, хотя новая модель должна обработать эту историю заново.
Новая модель начинает с холодного префикса, если у неё нет живой совпадающей записи в кеше
Агент обычно отправляет не только последнее сообщение пользователя. В каждый вызов могут входить системные инструкции, определения инструментов, состояние задачи, предыдущие результаты инструментов и история диалога. Кеширование промпта позволяет провайдеру повторно использовать вычисления для совпадающего префикса вместо новой обработки тех же токенов по обычному входному тарифу.
Учитывать нужно префикс, а не разговор как абстрактную сессию. Для попадания в кеш провайдер должен распознать подходящие начальные токены у той же модели. Кеш управляется провайдером, привязан к модели и лишь частично наблюдаем со стороны приложения. В текущей документации Brick это сформулировано как практическое правило: если у модели назначения нет живой совпадающей записи в кеше, она должна заново обработать переданный контекст по обычному тарифу ввода или записи в кеш. Но переключение не выселяет кеш исходной модели. Если роутер вернётся до истечения записи, эта модель по-прежнему сможет прочитать самый длинный совпадающий префикс: на трассах LiteLLM при возврате кеш оставался тёплым в 97,4% случаев при TTL 5 минут и в 99,3% при TTL 1 час. Смена модели — это холодный старт для новой модели, а не выселение кеша прежней.
Допустим, модель A уже получила префикс длиной 40 000 токенов. Следующий вызов добавляет 2 000 токенов. При работе на A подходящие 40 000 токенов оплачиваются по тарифу кеш-чтения, а добавленные 2 000 токенов — как свежий ввод, с учётом правил провайдера. Переход на модель B не переносит KV-состояние модели A. При первом переходе к этому префиксу модель B получает холодный промпт на 42 000 токенов и оплачивает его целиком по тарифу холодного ввода или записи кеша. Роутер выбрал новую цену не только для 2 000 токенов. Новая цена применяется и к истории. Истинная стоимость перехода — это разница: холодный префикс на B против префикса на A по тарифу кеш-чтения, а не против нуля.
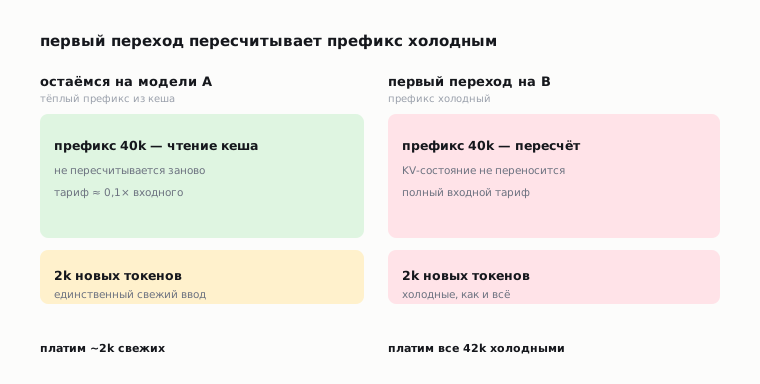
Первичное заполнение кеша в некоторых системах дороже обычного ввода. В тарифах Anthropic на кеширование промпта запись на пять минут стоит 1,25 базовой цены входных токенов, запись на час стоит 2 базовые цены, а чтение стоит 0,1 базовой цены. Запись в кеш — это первоначальная инвестиция, которая окупается за счёт более дешёвых чтений. Первый переход на новую модель может запустить этот цикл заново, но кеш ранее использованной модели при этом не обязательно исчезает.
У кеша есть и порог применимости. Правила кеширования OpenAI зависят от поколения модели. Для GPT-5.6 и новее минимальный кешируемый префикс составляет 1 024 видимых входных токена, а объём кеша учитывается по фактической подходящей границе. Для более ранних моделей типичный минимум составляет 2 048 токенов, а cached_tokens округляется вниз до кратного 128. Поэтому роутер должен использовать правила и поля биллинга конкретной модели, а не единый универсальный порог. Политика роутинга, которая считает каждый токен каждого вызова тёплым, приписывает биллингу несуществующую экономию.
Практическое следствие однозначно. Нужно учитывать токены кешированного префикса отдельно для каждой модели, а не только число токенов разговора. Сессия с историей на 60 000 токенов может оставаться холодной после изменения префикса. Вызов, чей общий подходящий префикс не достигает порога конкретной модели, не получает выгоды от кеширования. Состояние кеша является частью выбора модели.
Роутинг по вызовам подбирает возможности модели под каждый шаг
Роутинг по вызовам окупается, когда агентный цикл состоит из задач разной сложности. Сбор, действие и проверка являются удобными названиями, но сами ярлыки слишком грубы. Проверка может быть элементарным контролем схемы или самым трудным рассуждением во всей задаче. Роутеру нужны представление о способностях моделей и отдельная оценка требований текущего запроса.
Устроено это так: технический отчёт Brick оценивает каждую модель по шести группам возможностей, отдельно определяет требования запроса и выбирает исполнителя с помощью геометрического правила со штрафом за стоимость. Возможности модели не сводятся к одному общему рейтингу. Запрос занимает положение в многомерном пространстве, а штраф за цену сдвигает выбор к самой дешёвой модели, которая всё ещё соответствует оценённым требованиям.
Геометрическая часть имеет практический смысл. Один глобальный балл предполагал бы, что модель с преимуществом в одном типе работы пропорционально сильнее во всех остальных. Шесть измерений позволяют различать разные сочетания сильных и слабых сторон моделей. Оценка сложности привязывает решение к текущему вызову. Цена остаётся штрафом, а не единственной целью. Самую дешёвую модель следует выбирать только тогда, когда её возможностей достаточно для текущего запроса.
Из механики следуют и сценарии ошибок. Если сложность недооценена, запрос попадёт к слишком слабой модели. Повторная попытка или переход к резервной модели могут полностью съесть первоначальную экономию. Завышенная сложность смещает вызовы к дорогим моделям. Плохая оценка шести измерений превращает геометрическое правило в точный расчёт по неверным координатам. Переключение без состояния кеша в функции стоимости оптимизирует видимый шаг и выставляет счёт за невидимый префикс.
Роутинг по вызовам особенно силён при независимых шагах. Короткие промпты, редкое повторное использование префикса и уже холодные запросы уменьшают цену переключения. Большой разброс сложности даёт политике полезный сигнал. Десять обычных вызовов на недорогой модели могут оплатить один трудный вызов на сильной модели, особенно если каждый несёт мало истории.
Стратегия слабеет, когда харнесс на каждом ходу повторно отправляет растущую историю. Тогда выбранная модель сама становится частью состояния. Роутить по вызовам всё ещё можно, но функция стоимости должна учитывать стоимость холодной обработки префикса, ожидаемые повторы и возможность читать новый кеш в следующих вызовах. Без этих величин получается не семантический роутинг, а поиск строки в таблице цен.
Смена модели окупается, когда экономия на модели превышает дополнительную стоимость кеша
Правильно сравнивать не один пересчёт с одной экономией, а полную ожидаемую стоимость закрепления с полной ожидаемой стоимостью переключения на всём оставшемся участке работы. Запишем эту разницу так:
ΔC(H) = E[C_switch(H)] − E[C_stay(H)]
Переключаться следует, только когда ΔC(H) < 0. Каждая сторона суммирует категории биллинга провайдера по оставшимся вызовам — cache_write × тариф_записи + cache_read × тариф_чтения + uncached_input × тариф_ввода + output × тариф_вывода — плюс ожидаемую стоимость повторов, и считается отдельно для варианта «остаться» и варианта «переключиться», каждый со своим состоянием кеша.
Для одного шага разница имеет наглядный вид. Если обе модели одинаково считают токены, а стоимость самого роутера пренебрежимо мала, выражение упрощается до:
ΔC ≈ P × (W_B − R_A) + U × (I_B − I_A) + (Y_B × O_B − Y_A × O_A) + ΔE_retry
Здесь P — совпадающий префикс, тёплый на модели A и холодный на B, поэтому при переключении он оплачивается по тарифу записи или холодного ввода W_B модели B, а не по тарифу кеш-чтения R_A модели A; цена чтения исходной модели входит в формулу, а не считается бесплатной базой. U — свежий некешированный ввод шага, оплачиваемый по I_B на новой модели против I_A на прежней. Y_A и Y_B — ожидаемое число выходных токенов каждой модели, оплачиваемых по O_A и O_B. ΔE_retry — разница ожидаемой стоимости отказов и повторов между двумя моделями. Переключение оправдано лишь тогда, когда более дешёвые ввод и вывод на B перевешивают дополнительные P × (W_B − R_A), которые уходят на повторную обработку префикса.
Эта аппроксимация предполагает, что граница кеша заканчивается на P, а U оплачивается как обычный ввод. Если провайдер записывает в кеш и новый хвост, эти токены нужно перенести в слагаемое записи. В продакшене следует использовать фактические категории биллинга из ответа провайдера, а не выводить их только из длины промпта.
Если новая модель получит несколько следующих вызовов с тем же префиксом, её стоимость записи распределяется на эти будущие чтения и снижает эффективный W_B. Если роутер вскоре вернётся к прежней модели, нужно учитывать только ту часть контекста, которую она уже не сможет прочитать из живого совпадающего кеша. Полный пересчёт требуется лишь после истечения записи или изменения префикса. Для сравнения нужен горизонт: расчёт по одному вызову может ошибиться в обе стороны, поскольку не учитывает ни будущие чтения кеша на B, ни возможную стоимость возврата на A.
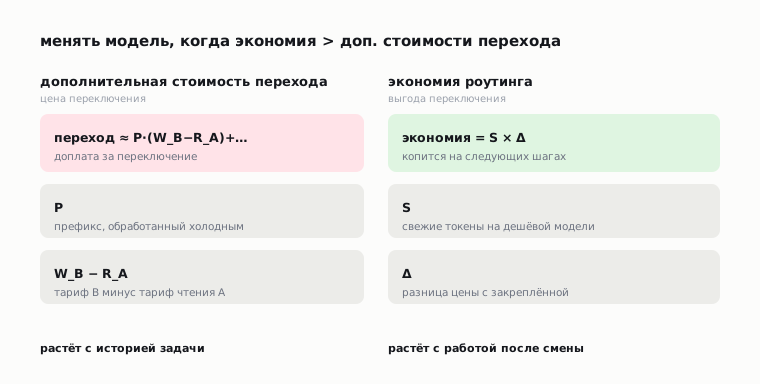
Даже эта упрощённая модель показывает главное. Слагаемое префикса P × (W_B − R_A) растёт вместе с историей задачи. Слагаемые экономии растут вместе с объёмом работы, назначенной более дешёвой модели после переключения. Поздний переход ради одной короткой проверки ставит большое число на сторону префикса и малое на сторону экономии, поэтому ΔC остаётся положительным и закрепление модели должно победить. Ранний переход перед серией коротких обычных вызовов сохраняет P небольшим и накапливает более дешёвые ввод и вывод на нескольких шагах, поэтому ΔC может стать отрицательным и роутинг по вызовам может выиграть.
Разница в тарифах должна быть достаточно большой, чтобы окупить дополнительную стоимость кеша. Если новая модель лишь немного дешевле, ей потребуется больше вызовов, чтобы её окупить. Чем больше разница в тарифах, тем быстрее окупается переход. Цена чтения Anthropic на уровне 0,1 базового тарифа делает отказ от многократно используемого тёплого префикса особенно дорогим, а коэффициенты записи 1,25 и 2 повышают входную цену нового кеша. Эти соотношения не доказывают безусловное преимущество закрепления модели, но показывают, почему нельзя выбирать маршрут только по тарифам без кеша.
В некоторых случаях формула почти не нужна. Если подходящий видимый префикс короче порога выбранной модели, терять попадание в кеш всё равно нечего. Для GPT-5.6 и новее этот порог составляет 1 024 токена, а для более ранних моделей — обычно 2 048. Для длинного стабильного префикса, который одна модель читает много раз, переключение ради маленького хвоста является плохим вариантом по умолчанию. Между этими крайностями стоит записывать фактические кешированные токены, записи кеша, холодный ввод, повторы и цены моделей. Оценки помогают задать политику. Счета помогают её исправить.
Цифра 80 процентов относится к кешированию, а не к роутингу
Важно не приписывать роутингу экономию, которую источник измерял для кеширования. Согласно таблице результатов, сравнительное исследование кеширования промпта у нескольких провайдеров показало снижение стоимости API примерно на 41–80% и сокращение времени до первого токена примерно на 6–31% в длинных многошаговых агентных сессиях в зависимости от провайдера и стратегии кеширования; при этом в абстракте авторы указывают диапазон 13–31%. Диапазон 41–80% показывает масштаб выгоды от кеширования, которую неудачная политика роутинга может частично потерять. Само исследование не измеряет потери, вызванные переключением моделей.
Роутинг и кеширование всё же могут усиливать друг друга. На 95 реальных агентных сессиях, включавших 8 174 API-вызова, бенчмарк LiteLLM с учётом провайдерского кеша сообщил о снижении стоимости на 37,4% для автороутинга с кешированием по сравнению с одной сильной моделью с включённым кешированием. Бенчмарк учитывает обе механики и отделяет их совокупную экономию от диапазона, полученного только за счёт кеширования.
Я отвергаю оба лозунга. Совет всегда закреплять модель отбрасывает разницу в цене шагов. Обещание экономить до 80% на каждом вызове заимствует результат кеширования для рекламы роутинга. Более точный вывод таков: роутинг с учётом кеша может быть дешевле одной сильной модели, если экономия от более дешёвых исполнителей превышает дополнительную стоимость кеша, отказов и повторных попыток.
Минимальный роутер должен помнить стоимость истории
Начать стоит с простого роутера, порога качества и резервной модели. Затем ему нужны данные для решения: текущая и рассматриваемая модели; отпечаток или граница префикса отдельно для каждой модели; число подходящих кешированных токенов; время последнего чтения и TTL либо оценка вероятности истечения; ожидаемое число оставшихся вызовов, входных и выходных токенов; тарифы обычного ввода, вывода, чтения и записи кеша; стоимость самого роутера; наблюдаемая частота отказов и повторов.
Рабочее правило простое: на выбранном горизонте нужно сравнить ожидаемую стоимость сохранения модели с ожидаемой стоимостью переключения. Для варианта с переключением учитываются фактическое состояние кеша новой модели, холодный ввод или запись в кеш, более дешёвые токены шага, стоимость самого роутера и ожидаемые повторы. Для варианта без переключения — оставшиеся чтения кеша исходной модели, свежий ввод, вывод и ожидаемые отказы. Модель следует оставить закреплённой, если переключение обходится дороже, и менять только тогда, когда ожидаемая экономия превышает эту разницу с достаточным запасом.
Закрепление модели за сессией подходит по умолчанию для длинного накопленного контекста, стабильных префиксов, многократного повторного использования и небольшой разницы в сложности шагов. Роутинг по вызовам подходит для коротких или естественно изолированных шагов, холодных префиксов, большого разброса сложности и достаточно большой разницы в тарифах. Гибридная стратегия может закреплять модель внутри одного этапа и пересматривать выбор на естественной границе между этапами, где префикс мал или кеш всё равно уже холодный.
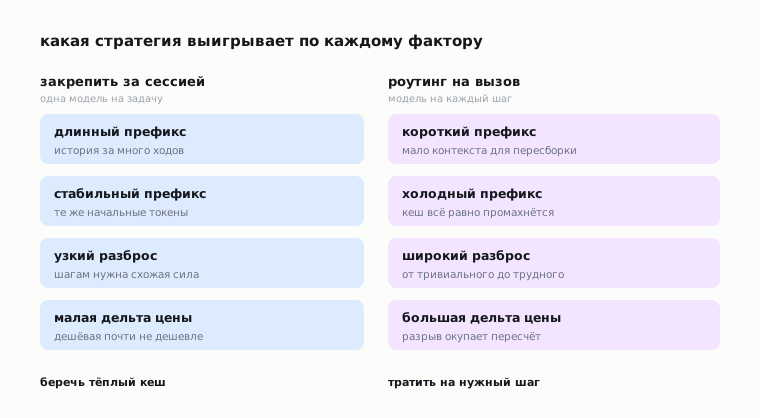
Именно такую конструкцию я бы выпускал в продакшен. Не верность одному лагерю, а роутер, который понимает возможности каждой модели и помнит цену их смены.